ホワイトペーパー・記事
AIデータ分析・BIに関する記事は、順次公開され次第こちらに表示されます。
View MoreAIデータ分析・BI
ダッシュボードとレポーティング、KPIモニタリング、予測分析、運用インテリジェンス。すべての数字を一つの合意された定義の上に築くので、会議での議論は「誰の数字が正しいか」ではなく「何をするか」になります。
つまずくところ
二つの部署に前四半期の売上を尋ねると、答えが二つ返ってくることは珍しくありません。どちらも、それぞれの定義では正しいのです。一方は受注額を数え、もう一方は計上された売上を数える。一方は返金を除き、一方は月曜日に更新された。その上に新しいダッシュボードを載せても、何も決着しません。議論に三つ目の数字が加わるだけです。意思決定を変える仕事は、グラフより前にあります。指標ごとに一つの定義を書き出し、持ち主を決め、それが現れるすべての場所で同じ方法で計算することです。
ダッシュボード上のどの数字も、その定義、元になったテーブル、最後に更新された時刻へとたどれます。その数字はどこから来たのかと聞かれたとき、答えは誰かの頭の中ではなく、画面の上にあります。
意思決定に必要だからではなく、データがあったからつくられた画面。公開初日には完成して見え、四半期の終わりには静かに見向きもされなくなっています。
提供内容
五つの領域です。多くの関与は、五つすべてではなく、パイプラインと一つの意思決定から始まります。
意思決定をする人のためのレポーティング。ウェアハウスにたまたまあるものではなく、その意思決定を中心に組み立てます。意思決定がリアルタイムならリアルタイムで、そうでなければ朝の更新で。たいていは後者で、しかもずっと安く済みます。
合意された少数の指標を自動で見張り、大事な範囲から外れたときには、名前のある担当者にアラートが届くようにします。持ち主のいないアラートは雑音であり、雑音こそがモニタリングを止めさせる原因です。
御社自身の履歴に基づく予測と推奨アクション。不確かさは隠さずに示します。自信たっぷりの一本線で描いた予測は、初めて外れた瞬間に会議室の信頼を失う、いちばんの近道です。
ほかのすべてを決める部分です。データを保持しているシステムから取り出し、クレンジングし、結合し、一度だけモデル化して、すべてのレポートがそこから読む形にします。労力の大半がここに注がれますし、注がれるべき場所でもあります。
分析を業務の横に置くのではなく、業務の中に組み込みます。例外は、誰かが開くのを覚えておかなければならないダッシュボードではなく、それが処理されるキューの中で知らされます。
進め方
これはどの意思決定のためのものか。誰が、どのくらいの頻度で下すのか。意思決定を変えない数字は、誰も保守する必要のない数字です。
その意思決定が頼るすべての指標について、何を数え、何を除き、どこから来て、誰が持つのか。何かをつくる前に書き出します。あとで起きる議論は、どれもこの段階に戻ってくるからです。
記録システムから取り出し、一か所でモデル化し、テストし、それを使うすべてのレポートが読みます。二つの画面が同じ指標を示すなら、二つは同じテーブルを読んでいます。
三段階目で、数字は合意され、一度だけ計算されるようになります。 残りの二つが、それを行動する人の目の前に置きます。
ダッシュボード、定期レポート、チームがすでに使っているチャンネルへのアラート、あるいは計画ツールの中の予測。意思決定がまさに行われているその瞬間に、誰かの目の前にある形を選びます。
モデル、テスト、指標の定義は、御社のリポジトリとウェアハウスに置かれ、引き継ぐ人のために書かれています。定義を変える必要が生じたら、御社のチームが一度変えれば、すべてのレポートがそれに従います。
はっきり言うと
ダッシュボードは意思決定をしません。ですから、意思決定の速さに倍率をつけるのは、数字の形をした当て推量です。お約束できるのはもっと狭く、そして確かめられることです。画面の数字が全員の合意した数字であること、それがどこから来て最後にいつ更新されたかを誰でも見られること、そして間違っているときは一か所で間違い、一か所で直ること。それで会議が速くなるかどうかは、御社ご自身で測れるはずですし、ぜひそうしていただきたいと考えています。
その前に
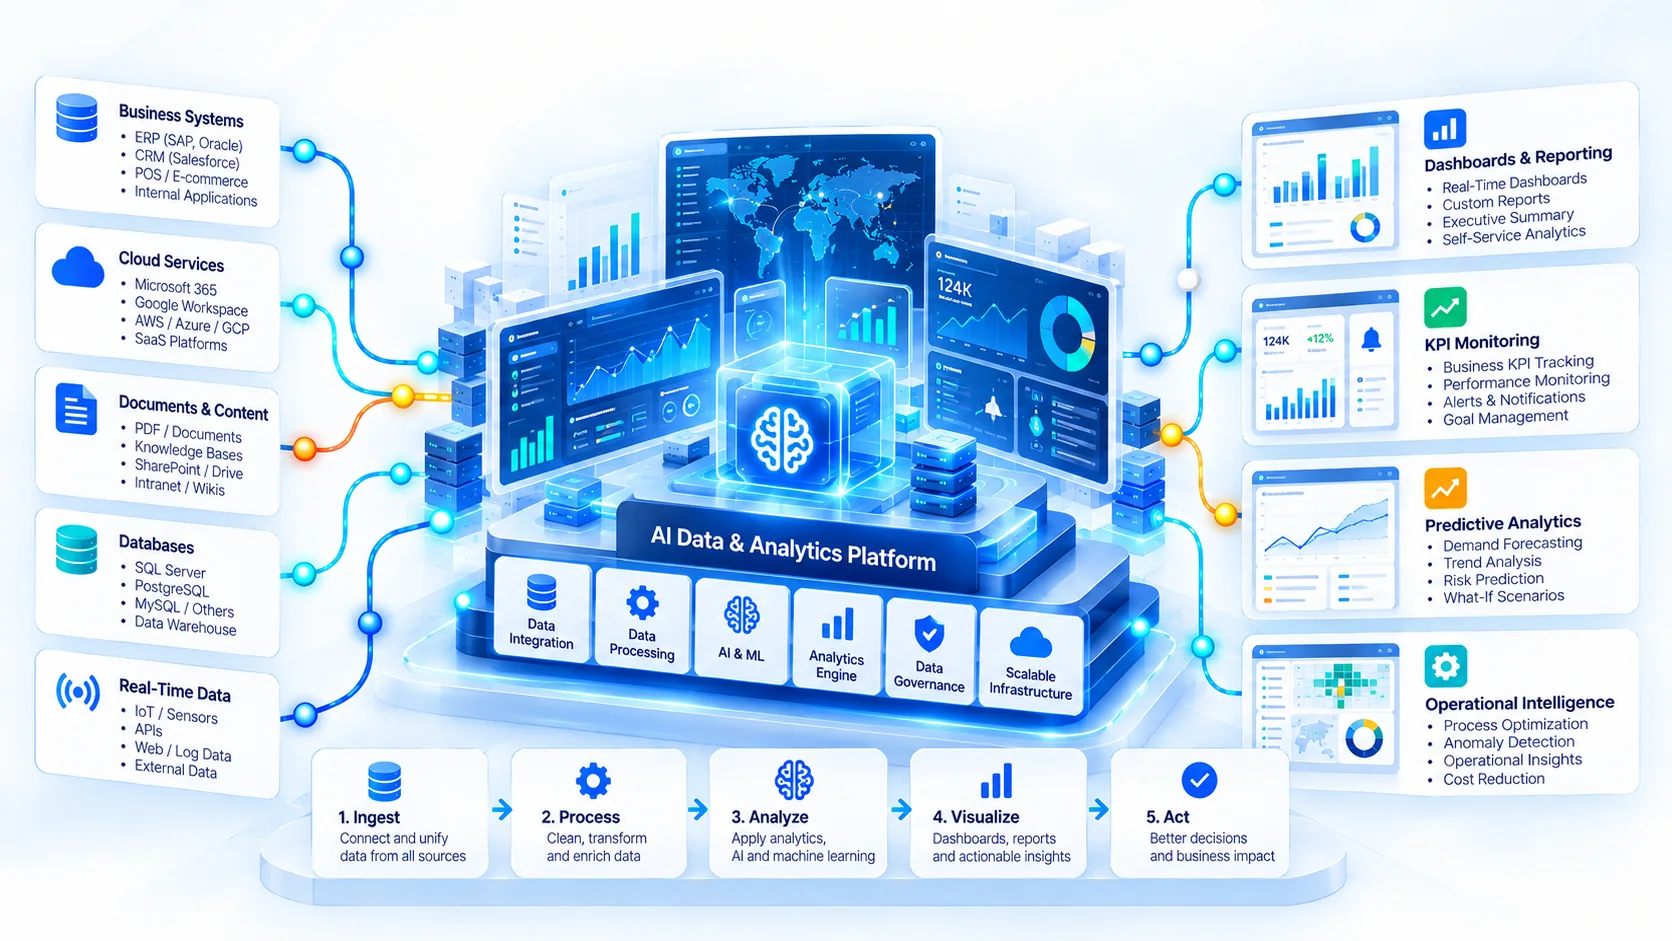
レポーティングにはPower BIとTableau、モデリングにはdbt、その下にSnowflake、BigQuery、Databricks。既製のツールが合わない場合は、カスタムのAIダッシュボードをつくります。たいていの正解は、すでにライセンスをお持ちのものです。新しいBIツールが定義の問題を解決することはまれで、しかも必ず移行作業を伴います。ページ上部の図に描かれたシステムは、業務データが置かれがちな場所の例であり、当社が構築した連携の一覧でも、当社が持つ提携の一覧でもありません。
いいえ。きれいなデータを待つことこそ、分析プロジェクトが止まる原因です。一つの意思決定と、それに必要な少数の指標から始め、それを正しくして、残りは後回しにします。誰かが数字を一つ見る前にデータ全体を片づけようとするのは、何も変えずに予算を使い切る、いちばん確実な方法です。
二か所です。そしてどちらについても、正確に言っておく価値があります。予測と異常検知は機械学習であり、その下にあるパイプラインの出来を超えることはありません。自然な言葉でデータに質問するのはもっと新しい使い方で、よく定義されたモデルの上ではうまく働き、散らかったモデルの上ではうまく働きません。これも、定義が先に来る理由の一つです。
その背後にある履歴の分だけで、それ以上ではありません。最近事業の形が変わったのなら、過去はあまり頼りにならず、予測もそう示すべきです。どの予測も一本線ではなく幅を示し、実際に起きたことと照らし合わせて検証されるので、頼る前にどこまで頼れるかがわかります。
システム統合・連携は、チームがすでに使っているツールの中にアシスタントを置き、その背後にあるシステムから答えられるようにするものです。こちらは、数字が信頼できるようになるための一歩手前の仕事です。パイプライン、指標ごとに一つの定義、そしてその上に築くダッシュボード、アラート、予測。アシスタントは自分が繰り返す数字以上には良くなれないので、二つはよく出会います。システム統合・連携。
次に
同じ数字を示すはずなのに、そうなっていない二つの報告書を送ってください。なぜ違うのか、どちらの定義を採るべきか、そしてすべての報告書が一致するには何が必要か——それはたいてい、新しいダッシュボードより小さな仕事です——をお返しします。